
26 de Octubre de 2026
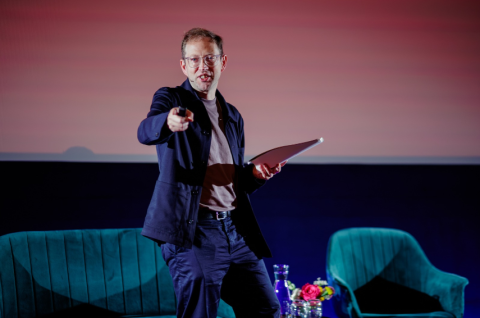
En un artículo para su blog, Ole Reissmann reflexionó sobre cómo la inteligencia artificial está transformando la relación entre los medios de información y sus audiencias. A partir de una conferencia en Mediatech Hub Conference 2026, el director de IA de SPIEGEL analizó el crecimiento de los agentes digitales, los desafíos que representan para el tráfico y los ingresos de los medios, y la necesidad de establecer nuevas reglas para proteger el valor y la integridad del periodismo.
Al comienzo de su intervención, Reissmann hizo referencia a Droneland, una serie que se estrenaría en MagentaTV, el servicio de streaming de Telekom, y cuya historia transcurre en un futuro cercano en el que la inteligencia artificial vigila a la población. La mención sirvió como punto de partida para abordar un escenario menos ficticio: el papel cada vez más importante de esta tecnología en el ecosistema informativo.
El autor, que trabaja en SPIEGEL, en Hamburgo, explicó con humor que su cargo como director de IA suele llevar a otras personas a preguntarle si ya ha probado los modelos más recientes. Una tarea difícil de mantener al día, dada la velocidad con la que aparecen nuevas herramientas.
Su planteamiento parte de una audiencia que crece rápidamente, consume los contenidos publicados por los medios y no se encuentra con los muros de pago de la misma manera que los lectores tradicionales. El detalle es que no se trata de una audiencia humana.
Según Reissmann, más de la mitad del tráfico web registrado el año anterior correspondió a actividad automatizada. En este grupo se encuentran los bots, los rastreadores y los agentes digitales: programas capaces de buscar información, leer contenidos y actuar en nombre de una persona o una organización. Su expansión está creando una nueva capa entre los medios de información y sus audiencias.
Para explicar este cambio, el autor organizó su intervención en torno a tres cuestiones: cómo ha evolucionado el sector, qué está ocurriendo actualmente y qué alternativas tienen los medios para encontrar su lugar en este nuevo entorno.
Cuando ChatGPT llegó al público, muchas empresas de medios comenzaron a explorar cómo la inteligencia artificial podía agilizar el trabajo y reducir costos. Entre sus primeras aplicaciones estuvieron la transcripción, la traducción, la elaboración de resúmenes y titulares, y la conversión de texto a voz. Algunas de estas herramientas ya están dando resultados.
La estrategia consistía en mantener los productos habituales, como artículos, videos y pódcast, e incorporar la IA a su producción. En SPIEGEL, por ejemplo, se incluyó la supervisión humana en las directrices internas para el uso de estas tecnologías.
Sin embargo, Reissmann advierte que esta aproximación responde principalmente a una pregunta sobre cómo producir contenidos, mientras deja en segundo plano otra transformación más profunda: el lugar al que se está desplazando la audiencia.
El autor denomina capa de los agentes al espacio que comienza a ocupar la inteligencia artificial entre las personas y los servicios digitales. La tecnología ya está presente en los teléfonos y navegadores, y también podría extenderse a dispositivos como las gafas inteligentes.
En lugar de abrir numerosos sitios web para buscar información, cada vez es más posible formular una petición directa a un asistente como planear un viaje, comparar ofertas o conocer las noticias del día en el Parlamento alemán. Estos sistemas también pueden recuperar consultas anteriores y ofrecer información relacionada con intereses que el usuario manifestó semanas atrás.
Aunque todavía representan una minoría, las personas que recurren a herramientas de IA para informarse son cada vez más numerosas. Reissmann cita un informe de Ofcom, el regulador británico de las comunicaciones, según el cual uno de cada cinco adultos del Reino Unido había utilizado herramientas de inteligencia artificial para consultar noticias durante el mes anterior a la publicación del estudio. Al mismo tiempo, los buscadores tradicionales también están incorporando funciones generativas, como AI Mode de Google.
En este contexto, el autor retoma las conclusiones de uno de los talleres de Signals at Scale, una serie de encuentros centrados en la transformación del ecosistema de la IA. El informe identifica cuatro cambios fundamentales:
- De la escasez a la abundancia.
- De las audiencias humanas a las audiencias de máquinas.
- De los formatos fijos a la información líquida.
- De la atención a la intención.
El concepto de formatos fijos se refiere a productos como artículos, videos, pódcast y series. Para un sistema de inteligencia artificial, todos ellos pueden convertirse en materia prima que se fragmenta y reorganiza para responder a las necesidades de una persona en un momento concreto.
Esto significa que una misma tecnología puede resumir un artículo periodístico, decidir qué programa recomendar o sustituir la reproducción de un contenido por una breve síntesis. En lugar de consumir directamente el producto original, el usuario recibe una versión seleccionada y adaptada por un intermediario.
Reissmann considera que esta transformación también modificará dónde se concentra el valor económico. Si producir contenidos se vuelve mucho más barato, la ventaja ya no dependerá exclusivamente de lo que elaboren los medios, sino también del lugar en el que las personas buscan respuestas. En ese escenario, la demanda podría concentrarse en las plataformas de IA, en detrimento de las marcas periodísticas.
Uno de los riesgos asociados es el llamado Google Zero: un escenario en el que los buscadores dejan de enviar tráfico a los sitios web de los medios. Aunque el autor señala que esta situación todavía no se ha materializado por completo, especialmente en el mercado alemán, advierte que el cambio ya está en marcha.
Ante este panorama, los medios han recurrido principalmente a tres estrategias: bloquear los bots, emprender acciones legales y conceder licencias para el uso de sus contenidos. Para Reissmann, ninguna de ellas resuelve por sí sola el problema.
Bloquear los rastreadores parece sencillo en teoría. Los sitios web pueden utilizar un archivo de texto llamado robots.txt para indicar qué sistemas automatizados tienen permiso para acceder a sus páginas. Sin embargo, estas instrucciones son voluntarias y no todos los bots las respetan.
El autor menciona datos de TollBit que indican que, a finales de 2025, alrededor del 30% de los rastreos realizados por sistemas de IA ignoraba las reglas establecidas en estos archivos.
Por eso, algunos medios están reforzando sus mecanismos de protección mediante verificaciones de bots, técnicas de identificación de dispositivos y pruebas CAPTCHA, como las que piden seleccionar todas las imágenes que contienen semáforos. El inconveniente, señala Reissmann con ironía, es que también los suscriptores humanos deben superar estas pruebas.
Además, existen servicios capaces de resolver estos acertijos de forma automatizada. En consecuencia, bloquear los bots no necesariamente impide el acceso a los contenidos, puede limitarse a encarecer el proceso de rastreo.
El problema también está en determinar qué se considera un bot. Algunos rastreadores recopilan contenidos para entrenar modelos; otros sirven para alimentar buscadores con IA. También existen herramientas que visitan un sitio web para responder una consulta puntual y agentes que operan desde el navegador y el computador de una persona, con su sesión iniciada y una suscripción activa.
En estos últimos casos, la distinción entre un bot y un lector se vuelve menos evidente. Como recuerda Reissmann, el navegador siempre ha utilizado el término user agent para identificar el software que actúa en nombre del usuario. La diferencia es que ahora esos agentes pueden asumir tareas mucho más complejas.
Por eso, el autor considera que la pregunta no debería limitarse a determinar si una visita procede de un bot o de una persona. Lo importante es establecer en nombre de quién actúa el agente y bajo qué condiciones accede a la información.
El problema de las licencias
La concesión de licencias es otra de las respuestas que han adoptado los medios. Algunos ya han firmado acuerdos con empresas de IA para permitir el uso de sus contenidos a cambio de una compensación económica. Sin embargo, Reissmann advierte que estos contratos pueden implicar la pérdida de dos elementos fundamentales como el significado de las noticias y los datos sobre las audiencias.
El primer riesgo está relacionado con la integridad de la información. En el periodismo, cada palabra puede ser determinante, especialmente cuando se informa sobre acusaciones o sospechas. En Alemania existe un término específico para esta práctica, Verdachtsberichterstattung, que hace referencia a la cobertura periodística de casos en los que una persona es sospechosa de haber cometido una falta o un delito.
En estas circunstancias, los medios deben dejar claro que se trata de una sospecha, incluir la versión de la persona señalada y revisar cuidadosamente la redacción de las publicaciones, incluso con asesoría legal.
Pero cuando un sistema de IA resume una noticia, puede omitir elementos esenciales. Una expresión como "presuntamente" podría desaparecer, al igual que la respuesta de la persona involucrada, quizá porque aparece varios párrafos después. El resultado puede ser un resumen que atribuya al medio una afirmación que nunca hizo y que, incluso, no habría podido publicar en esos términos.
El segundo riesgo es la pérdida de información sobre las audiencias.
Los medios digitales suelen recopilar datos sobre el comportamiento de sus lectores, qué artículos consultan, desde dónde llegan, cuánto tiempo permanecen en una página y si terminan suscribiéndose. Aunque no cuentan con la misma cantidad de información que plataformas como Meta o Google, estos datos son importantes para tomar decisiones editoriales y comerciales.
Con un acuerdo de licencia, en cambio, un medio puede recibir una suma de dinero sin saber cómo se utiliza su contenido. No necesariamente conoce qué preguntas respondió su periodismo, con qué frecuencia se consultó, quiénes lo utilizaron o junto a qué otras fuentes apareció.
Reissmann compara esta situación con los primeros acuerdos entre las plataformas de streaming y los productores audiovisuales. Durante un tiempo, estos últimos entregaban sus programas y recibían un pago, pero no tenían acceso a información detallada sobre su rendimiento. Según el autor, los medios están empezando a aceptar condiciones similares con las empresas de inteligencia artificial.
La paradoja es que las plataformas de IA tienen acceso a una enorme cantidad de información sobre las necesidades de sus usuarios. Mientras una búsqueda tradicional solía consistir en dos o tres palabras, una instrucción o prompt puede revelar con mucho más detalle qué intenta resolver una persona. El problema para los medios es que esas consultas se realizan en las plataformas de IA, no en sus propios sitios.
Cómo encontrar un lugar en el nuevo ecosistema
Para entender quién captura el valor en este entorno, Reissmann retoma una de las conclusiones del taller de Signals at Scale: cada vez más, ese valor se concentra en la capa de IA y no en los medios que producen los contenidos.
Las plataformas conocen tanto la información que consumen las personas como la intención detrás de sus consultas. Además, controlan la interfaz desde la que se accede a las respuestas y, en algunos casos, cuentan con los datos de pago de los usuarios.
De este modo, aunque el valor se genere a lo largo de toda la cadena, tiende a concentrarse cerca del consumidor. El periodismo, en cambio, ocupa una posición más alejada, en las etapas previas del proceso.
Ante esta situación, el autor identifica dos caminos para los medios. El primero consiste en organizarse y fortalecer su posición dentro de la cadena de producción y distribución, de manera que puedan construir modelos de negocio sostenibles. El segundo es acercarse nuevamente a las audiencias mediante productos, interfaces y, eventualmente, agentes propios.
Reissmann también plantea una tercera responsabilidad, especialmente para los medios de servicio público, financiar estándares e investigaciones que no necesariamente atraen suscriptores, pero que son importantes para la democracia liberal. Se trata de trabajos cuyo valor social no siempre se traduce en ingresos comerciales y que, por tanto, necesitan otras formas de respaldo.
¿Qué necesitan los medios para relacionarse con los bots?
1. Identidad
Si los medios quieren establecer una relación con los agentes digitales, estos deben poder identificarse.
Una alternativa es vincular las suscripciones existentes. El usuario podría informar a su asistente de IA que tiene una suscripción a un medio y conectar ambas cuentas, de forma similar a como se vinculan las suscripciones a pódcast en Spotify o Apple Podcasts.
La tecnología para hacerlo ya existe. Entre las herramientas disponibles están OAuth, un protocolo de autorización, y MCP, el Protocolo de Contexto de Modelos. Este mecanismo permitiría que los agentes accedieran a determinados contenidos en nombre de usuarios que ya cuentan con una suscripción.
Sin embargo, Reissmann recuerda que la mayoría de las personas todavía no paga por noticias. Si los medios quieren seguir siendo visibles y permitir que nuevos usuarios los descubran, tendrán que ofrecer alternativas que también funcionen para quienes no tienen una suscripción.
Una posibilidad sería crear un registro de agentes que permita identificar quién los opera, como una matrícula que vincule cada sistema con su responsable.
Ya existen iniciativas en esa dirección. Una de ellas es Web Bot Auth, un mecanismo mediante el cual la empresa responsable de un agente publica una clave y cada solicitud incluye una firma digital. Así, el sitio web puede comprobar quién está detrás de la petición, en lugar de confiar únicamente en la identidad que el propio agente declara.
El desarrollo de este estándar cuenta con un grupo de trabajo en el IETF, el Grupo de Trabajo de Ingeniería de Internet, desde octubre de 2025. Aunque todavía no está terminado, empresas como Cloudflare, Akamai y AWS ya verifican este tipo de firmas. Según el artículo, el agente de OpenAI también firma sus solicitudes.
2. Procedencia y significado
Identificar al agente es solo una parte de la solución. Los medios también necesitan herramientas para establecer de dónde procede la información y evitar que se pierda su significado cuando se transforma o reutiliza.
Reissmann menciona varias iniciativas que ya trabajan en este campo. Una es C2PA, conocida como Content Credentials, un estándar que permite registrar información sobre el origen y las modificaciones de contenidos como textos, imágenes y videos. Según el autor, varios organismos de radiodifusión ya lo utilizan.
Otra iniciativa es RSL, Really Simple Licensing, que permite definir condiciones para el uso de los contenidos digitales. A diferencia de robots.txt, que establece si un rastreador puede acceder a un sitio, RSL busca especificar bajo qué condiciones puede utilizarse ese material.
Esto permitiría, por ejemplo, autorizar las búsquedas tradicionales, pero no las búsquedas impulsadas por IA; establecer pagos por rastreo o por respuesta, o exigir que se reconozca la fuente. Más de 1.500 organizaciones respaldan el estándar, entre ellas Associated Press y The Guardian. Sin embargo, RSL no puede hacer cumplir sus condiciones por sí solo, necesita la participación de intermediarios como Cloudflare o Akamai.
También está News Atom, una iniciativa que busca asignar metadatos a cada oración o afirmación de una noticia, para que sus elementos puedan identificarse individualmente.
El problema, explica Reissmann, es que estas herramientas todavía no funcionan de manera integrada. Además, la atribución del significado es uno de los aspectos menos desarrollados. Mientras que hoy es posible demostrar que una fotografía no ha sido alterada, verificar que una oración conserve su sentido original resulta mucho más difícil.
La dificultad aumenta cuando un sistema de IA utiliza un contenido para elaborar una respuesta propia. En ese proceso, las señales que daban contexto a la información original pueden desaparecer.
Por ello, el autor plantea la necesidad de establecer nuevas reglas. Cada afirmación incluida en una respuesta generada por IA debería señalar la fuente de la que procede. Además, algunos elementos deben mantenerse unidos, por ejemplo, una acusación y la respuesta de la persona señalada.
Una regla especialmente importante sería conservar el grado de certeza de la fuente original. Si una noticia habla de algo que ocurrió "presuntamente", la respuesta generada también debería mantener esa precisión. La información puede expresarse con mayor cautela durante el proceso, pero no debería presentarse con una certeza superior a la que permite la fuente.
Esto podría abrir una nueva dimensión del trabajo editorial. Además de comprobar que cada palabra sea correcta, las redacciones tendrían que determinar qué elementos deben conservarse cuando una máquina transforma sus contenidos. Para que el sistema funcione, sostiene Reissmann, las plataformas de IA deberán reconocer la importancia de estas condiciones y estar dispuestas a pagar por ellas.
3. Datos y pagos
Los acuerdos entre medios y empresas de IA deberían incluir informes detallados sobre el uso de los contenidos, no limitarse a una compensación económica. Los medios necesitan saber qué publicaciones se utilizaron, con qué frecuencia y en qué contexto.
Además, si los agentes acceden al periodismo a través de interfaces propias, API o servidores MCP de los medios, estos podrían obtener información directa sobre las consultas y el uso de sus contenidos.
El pago, sin embargo, sigue siendo un desafío. Durante años, muchos medios se han resistido a cobrar por cada artículo porque ese modelo difícilmente permite sostener una redacción de cientos de personas.
Actualmente, varias empresas están desarrollando mercados para comercializar contenidos con sistemas de IA. Entre ellas están TollBit y ProRata, además de las grandes compañías tecnológicas. Sin embargo, Reissmann considera que los pagos ofrecidos por cada rastreo todavía son bajos y que la demanda no se ha consolidado.
Mientras existan noticias gratuitas en sitios que dependen del alcance, medios públicos y plataformas como Wikipedia, muchas consultas podrán resolverse sin que las empresas de IA tengan que pagar directamente a los medios de información.
Aun así, el autor señala que el pago puede funcionar en ámbitos especializados que requieren información actualizada en tiempo real, como ocurre con Bloomberg.
También hay avances en la infraestructura técnica para facilitar estas transacciones. Uno de ellos es el código de estado HTTP 402, Payment Required (pago requerido), que permite indicar que el acceso a un recurso exige un pago. Un sitio web podría responder a un agente que una página cuesta un centavo y ofrecerle un mecanismo para pagarla. Cloudflare lanzó un servicio para este tipo de transacciones en julio de 2026.
Otra iniciativa es AP2, el Agent Payments Protocol, un protocolo que busca permitir que los agentes realicen pagos con una autorización verificable. La propuesta contempla que el agente lleve una prueba firmada, denominada mandato, que demuestre que una persona le permitió realizar una compra hasta un límite determinado.
Reissmann destaca que Cloudflare aparece en varias de estas soluciones: participa en el bloqueo de bots, la verificación de identidades y la gestión de pagos. En conjunto, estas funciones forman parte de la infraestructura emergente de la web de agentes, un ecosistema que también introduce nuevos intermediarios entre los medios y sus audiencias.
Por ahora, el mercado parece estar organizándose en distintos niveles. Algunos medios consiguen acuerdos que les garantizan una suma fija, mientras que otros quedan por fuera y deben competir por pagos asociados al rastreo de sus contenidos. No obstante, el autor advierte que todavía es temprano para determinar cómo evolucionará este modelo.
Los principales beneficiarios de los acuerdos conocidos tampoco son necesariamente los medios tradicionales. Según las cifras citadas en el artículo, Amazon pagaría entre 20 y 25 millones de dólares anuales al New York Times, mientras que Reddit recibiría alrededor de 60 millones de dólares al año de Google y unos 70 millones de OpenAI.
La comparación es significativa, el New York Times cuenta con 175 años de historia periodística y una redacción de 2.000 personas, mientras que Reddit reúne comunidades en las que los usuarios hacen preguntas y comparten respuestas con sus propias palabras.
Para Reissmann, esta situación recuerda lo ocurrido en la industria musical. Primero, plataformas como Napster popularizaron el acceso gratuito a la música y las discográficas respondieron con demandas. Después llegó Apple con canciones a 99 centavos, una alternativa más conveniente que la distribución gratuita. Finalmente, se consolidaron los servicios por suscripción.
En ese proceso, una parte importante del dinero terminó concentrándose en las plataformas, la distribución y la tecnología. Aunque parte de los ingresos llega a la industria musical, los artistas reciben solo una fracción.
El autor observa una dinámica similar en el sector informativo: muchos medios están cerrando sus contenidos y bloqueando los rastreadores mientras intentan comprender las consecuencias del nuevo escenario. Frente a ello, considera fundamental que la industria trabaje de manera conjunta.
Por esa razón, destaca la importancia de iniciativas como la coalición SPUR, los organismos encargados de desarrollar estándares y las medidas regulatorias que buscan establecer condiciones para el uso de los contenidos periodísticos por parte de las plataformas de IA.
Construir la nueva capa o convertirse en un intermediario invisible
Para cerrar su reflexión, Reissmann retoma una idea de Shuwei Fang: "hay que desconfiar de las soluciones que exigen el menor cambio posible". A su juicio, bloquear, demandar y conceder licencias son respuestas que permiten a los medios mantener gran parte de sus prácticas actuales, pero no necesariamente los preparan para los cambios que se avecinan.
El autor también recurre a un concepto de la industria de las telecomunicaciones: dumb pipe, expresión que describe a una empresa que transporta información sin controlar los servicios ni capturar el valor económico que circula por su infraestructura.
Con un comentario irónico sobre Droneland, la serie mencionada al comienzo de su intervención, Reissmann vuelve al punto central de su argumento, los medios corren el riesgo de convertirse en simples proveedores de contenidos para plataformas que controlan la relación con las audiencias y se quedan con buena parte de los ingresos.
El periodismo sigue siendo necesario, quizá más que nunca. El desafío, concluye el autor, es participar activamente en la construcción de esta nueva capa tecnológica. De lo contrario, los medios podrían terminar limitándose a transportar información mientras otros deciden cómo se distribuye, quién la consume y quién obtiene el beneficio económico.
Otras noticias

Las condiciones del Times para licenciar contenidos a la IA
El mayor robo de trabajo en la historia de la humanidad
Las condiciones del Times para licenciar contenidos a la IA